
作者:小编 发布:2026-10-22
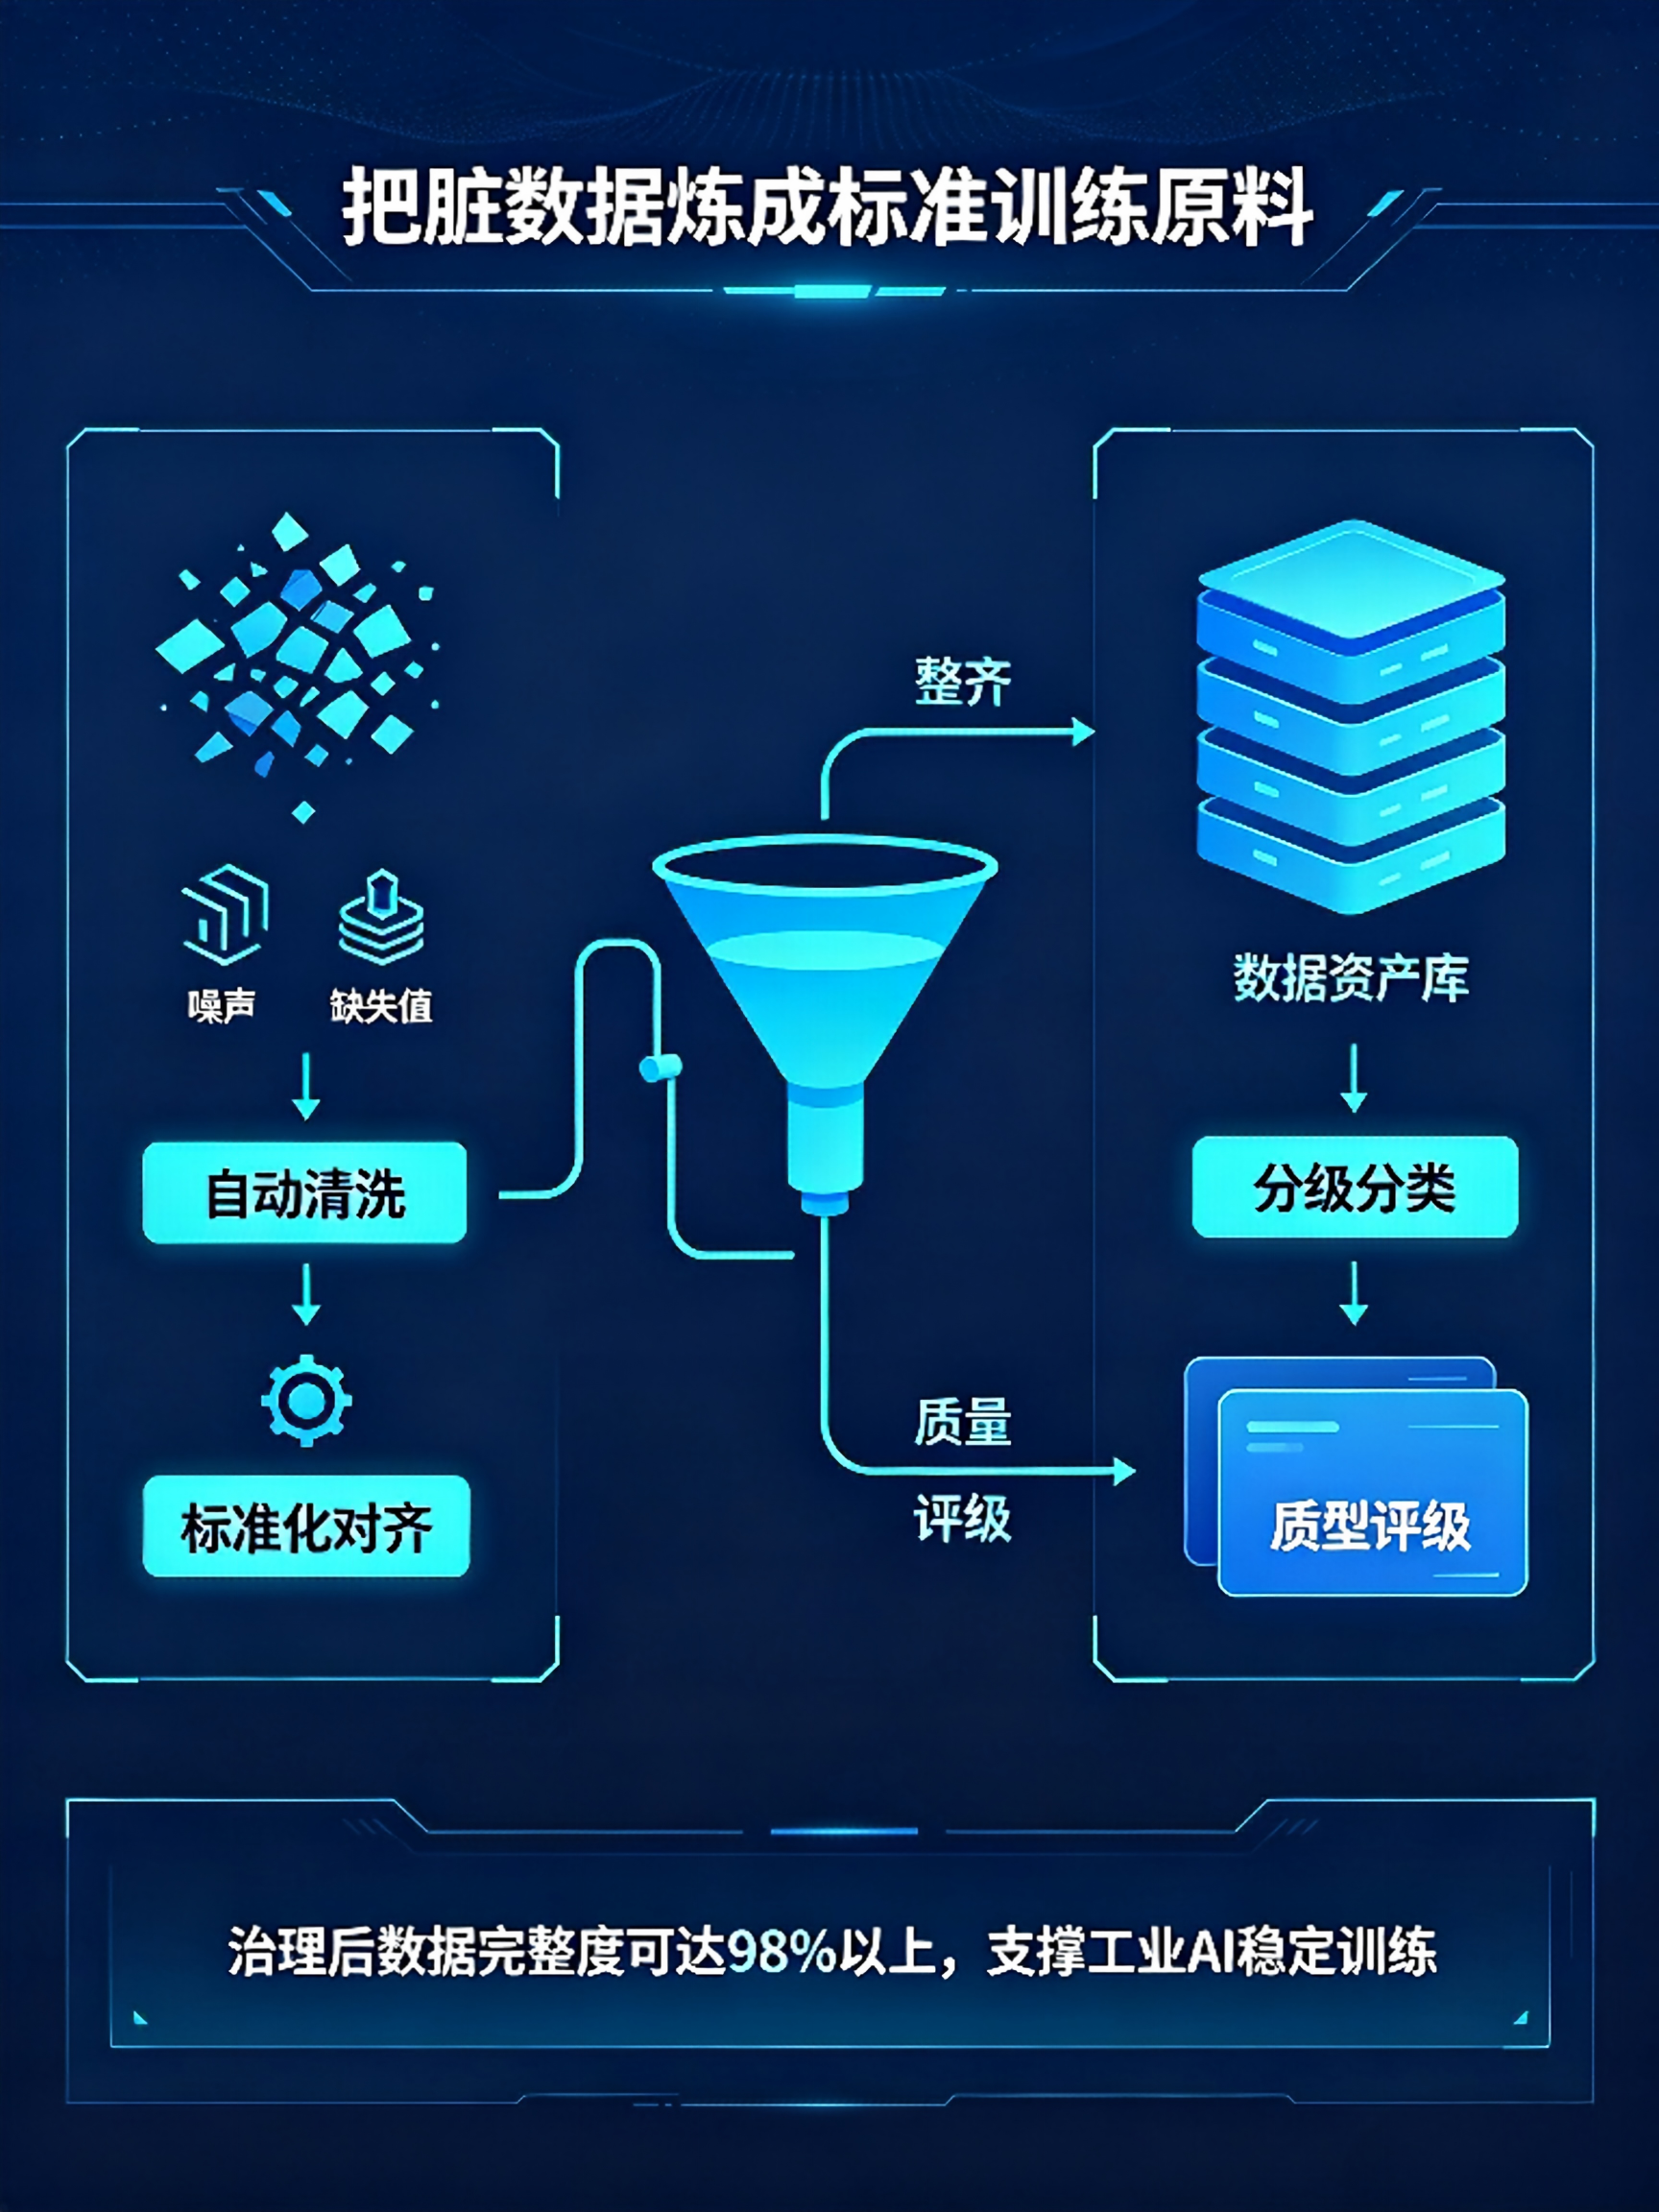
数据治理里有几项公认的体力活,恰好是 AI 格外擅长接管的。先说数据盘点,从"挨家挨户问"变成"自动扫描"——工具扫描数据库和文件系统,大模型读取字段名、表注释和 SQL 脚本,推断业务含义、打标签、画血缘图,原本几个月的工程量几周就能出雏形,人工只做校对,不用再从零访谈。
数据标准和主数据这块,AI 做翻译。同一台变压器在三个系统里有三种叫法,AI 做实体对齐和智能映射,人只确认拿不准的。分类分级让敏感数据自己现形:AI 全量扫描库表和文档,识别个人信息与重要数据,自动挂密级标签,先把底兜住,还顺带给出修复建议。用数环节也变简单,对话式取数成熟后,说一句"上月各台区线损排名",结果直接就出来,业务人员不用再等 IT 排期。过去这类取数要写 SQL、走工单、等排期,业务等不及就自己导表,反而又制造一批无主数据;对话式取数把出口统一了,数据的"出"也回到治理手里,权限和口径才有机会收紧。
中卓盛安在配合能源企业落地时,会把非结构化档案的激活,归到「通识/专识数据集分层」这套方法里:地质报告、设计文件、事故案例先用 OCR 和知识图谱结构化,再按通识层(行业通用规范、设备手册、国标条文)与专识层(本厂工艺参数、老师傅经验、历史处置记录)分别治理、分层供给。通识层解决"能不能被通用模型读懂",专识层解决"懂不懂这家厂的真实情况"——两步拆开,模型幻觉才有治。这一步正是老师傅经验"存下来、传下去"的路径,也是后续训练智能体的语料底座。如果反过来,把通识和专识混在一起喂给模型,结果往往是"听起来都对、用起来都错"——通用规范掩盖了本厂的工艺细节。分层之后,专识层可以独立迭代、独立授权,既保护 know-how,也让模型答案更贴地。
一般建议先从"数据盘点"和"分类分级"两块切入,投入小、阻力低,容易拿到头一批可展示成果,再用成果反推组织继续投入。
分层治理一旦跑起来,变化发生得比较明显的是非结构化文档。工艺卡片、检修记录、设备说明书这类材料过去散在各台电脑和文件柜里,要找一份得靠问人;分层之后按主题域归库、按密级定权限,检索从「翻资料」变成「查目录」,调用的人多了,文档的更新频率也跟着上来。要让这件事持续,得把入库审核规则先定好:什么样的文档能进、谁审、多久复核一次,规则不清,库很快会重新变乱。
标签:郑州,个人副业数据代理,选哪家
上一篇: 北京北奥特交通安全科技有限公司 小区停车场翻板路障检修费用情况
下一篇: 长春小盒包装哪家适合日常礼品包装需求
版权声明:文章观点仅代表作者观点,不代表本站观点。